Warum wir Open-Weight-Modelle brauchen — und wo Local Inference im Oktober 2026 tatsächlich steht
2026-10-21 · Julian Weber
Alle zwei Wochen fragt mich jemand: „Warum sollte ich ein Modell auf eigener Hardware betreiben, wenn Claude nur eine URL weit entfernt ist?"
2023–2024 hat sich die Frage von selbst beantwortet: Nimm die API. 2026 beantworten meine eigenen Logs sie andersherum. In den letzten 28 Tagen sind 85 % der Token, die meine Agenten verarbeitet haben, über Open-Weight-Modelle auf meinen zwei Kisten zu Hause gelaufen — überwiegend Qwen3.8 Flash Next und Qwen3.8-27B, oft mit mehreren Agenten parallel. Claude hat die restlichen 15 % abbekommen. (Gemessen via agentsview)
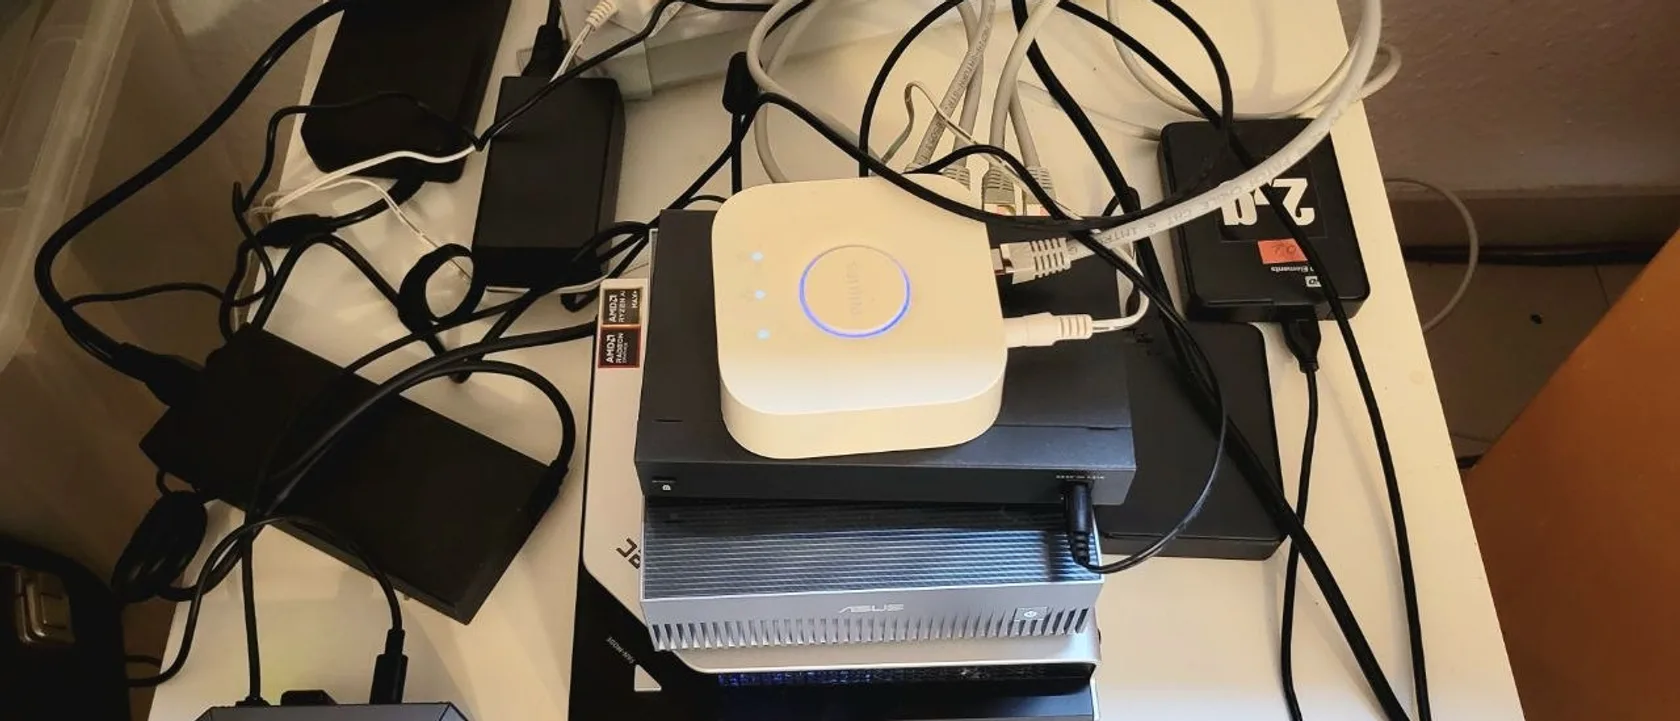
Das ist kein Zufall. Als ich mir vor gut einem Jahr meinen Strix Halo gekauft habe, habe ich mir eine Quest gegeben: lokale Modelle zuerst, geschlossene APIs nur dort, wo lokal nicht reicht. Ein Jahr später ist das keine Spielerei mehr. So arbeite ich. Kurzfassung: Open Weights sind längst kein Trostpreis mehr, Self-Hosting ist nicht automatisch billiger, und für meine eigene Arbeit — und für jeden Workload, bei dem die Daten das Haus nicht verlassen dürfen — ist lokal inzwischen der Standard und nicht der Kompromiss.
Erst mal das, was die meisten übersehen: Open Weights sind kein Trostpreis mehr
Nimm dir eine einzige Woche in diesem Monat.
Am 15. Oktober hat Meta die Weights von Muse Spark Open veröffentlicht — 816B Parameter, ~42B davon pro Token aktiv, nativ multimodal und aktuell an der Spitze der Open-Weight-Leaderboards. Am Tag darauf brachte Reflection AI Beam heraus, StepFun veröffentlichte Step 5 Preview, NVIDIA lieferte Nemotron 3.5 Super VL aus, und DeepSeek schob ein Update für V4.1 Flash nach. Fünf Open-Weight-Releases. Drei Tage. Und Mistral Large 4 — eine Billion Parameter, ~52B aktiv, Europas erstes Open-Weight-Modell dieser Größe — legt seine Weights am 31. Oktober offen.
Allein im Oktober 2026 sind rund 22 Open-Weight-Modelle erschienen, von Smartphone- bis Rechenzentrumsgröße. Das sind keine Krümel, die bei den Closed Labs vom Tisch fallen. Das ist ein Markt.
Irgendwann 2025 hat die Leistungskurve ihre Form geändert, und zurückgegangen ist sie seitdem nicht. Im April habe ich mir den Artificial Analysis Intelligence Index für die Modelle notiert, die mich interessieren: GPT-5.5 bei 60, Claude Opus 4.7 und Gemini 3.1 Pro bei 57, das beste Open-Weight-Modell bei 54. Seitdem wurde der Index neu kalibriert, und wer Scores über Indexversionen hinweg vergleicht, lügt dich an. Artificial Analysis bewertet alte Modelle aber bei jeder neuen Version neu, und damit stellt die aktuelle (v4.3.2) die Flaggschiffe vom April und die beiden Modelle, mit denen ich den ganzen Tag arbeite, auf dieselbe Skala. Zu ihren Evaluations gehört Terminal-Bench 4.0, der agentische Terminal-Benchmark, der meiner Coding- und DevOps-Arbeit am nächsten kommt:
| Modell | Release | Läuft auf | AA Intelligence Index v4.3.2 |
|---|---|---|---|
| Claude Opus 5.5 (max) | Sep. 2026 | API | 58 |
| Claude Opus 4.7 (max) | Apr. 2026 | API | 41 (Schätzung von AA) |
| Qwen3.8 Flash Next | Aug. 2026 | meinem Schreibtisch | 40 |
| GPT-5.5 (xhigh) | Apr. 2026 | API | 38 |
| Qwen3.8-27B (xhigh) | Aug. 2026 | meinem Schreibtisch | 34 |
| Gemini 3.1 Pro Preview | Feb. 2026 | API | 30 |
Die Frontier Modelle sind weitergezogen: Opus 5.5 liegt 18 Punkte über allem, was ich lokal betreibe. Aber das Modell auf meinem Schreibtisch schlägt inzwischen zwei der drei Flaggschiffe vom April und liegt beim dritten nur einen Punkt dahinter. Vor sechs Monaten gab es diese Intelligenz nur als API für 10–11 $ pro Million Token. Heute ist sie eine Datei. Dieser Abstand von etwa einem halben Jahr ist die eigentliche Form der Kurve.
Das meiste Feuer kommt dabei aus dem Osten: DeepSeek, Moonshot, Alibaba, Xiaomi, Z.ai. Dazu Meta, das ab und zu wieder mitspielt, und Aleph Alpha, das am 5. Oktober Kolibri veröffentlicht hat — ein deutsch-englisches 78B-Modell unter Apache 2.0 mit ~3,5B aktiven Parametern, ausdrücklich gebaut für Daten, die auf den eigenen Servern bleiben müssen. Wenn dir jemand erzählt, Open Weights seien doch selbstverständlich: Metas kostenpflichtiges Muse Spark 1.1 im Juli war ein Bruch mit der eigenen Open-Weight-Geschichte. Dass es Weights zum Download gibt, ist kein Naturgesetz. Es ist eine Geschäftsentscheidung eines Unternehmens, jedes einzelne Mal, und gefragt wirst du dabei nicht.
Genau das ist das Argument.
Warum wir sie brauchen — die vier Gründe, die wirklich tragen
1. Keine fremden Bedingungen entscheiden, ob dein System läuft
Eine geschlossene API kann dein Wettbewerber abkündigen, sie kann im nächsten Quartal teurer werden, ausgerechnet in deiner Lastspitze gedrosselt werden oder dich mit Version 3.2 des SDK zu neuen Nutzungsbedingungen zwingen. Open Weights sind eine Datei. Du lädst sie herunter, pinnst die Checksumme, und 2031 läuft sie immer noch.
Abgekündigte Modelle legen schon heute Produktionspipelines lahm. Liegen die Weights auf deiner Platte, entscheidest du, wann du upgradest — in deinem Wartungsfenster. Wer einen Service verkauft, bei dem KI auf dem kritischen Pfad liegt, für den ist dieser Unterschied nicht philosophisch, sondern vertraglich.
2. Datensouveränität gibt es nicht als Add-on
Für meine Kunden — überwiegend KMU im Saarland und in Luxemburg, dazu ein paar mit Verschwiegenheitspflichten — ist die spannende Frage nie „Welches Modell hat den höchsten Score?". Sondern: Wer taucht alles im Pfad meiner Daten auf?
Nutzt du ein gehostetes Modell, muss deine Datenschutzdokumentation den Anbieter abdecken, seine Unterauftragsverarbeiter, den Transfermechanismus und ein Data Processing Agreement, das du ohne den Anbieter nicht prüfen kannst. Läuft das Modell auf deiner eigenen Kiste, besteht die Liste der Beteiligten aus: dir. Damit fallen zwei der dicksten Arbeitspakete einer Cloud-DPIA weg — Drittlandübermittlungen und der Wildwuchs an Unterauftragsverarbeitern. Für Privacy by Design nach Art. 25 ist das ein echter Gewinn.
Hier muss man genau sein, weil viele die falsche Version dieses Arguments verkaufen: Weder die DSGVO noch der EU AI Act schreiben vor, dass KI on-premise laufen muss. Keiner der beiden Texte nennt überhaupt ein Deployment-Modell. Self-Hosting ändert nichts daran, welche Pflichten für dich gelten — ein HR-Screening-Tool hat nach dem AI Act dieselben Pflichten, egal ob es vom Schreibtisch antwortet oder über die API eines Anbieters in einer anderen Rechtsordnung.
Was Self-Hosting ändert, ist deine Fähigkeit, Compliance nachzuweisen. Die Logs gehören dir. Du pinnst genau die Modellversion, die in deiner Dokumentation steht. Du beantwortest die Frage eines Auditors, ohne ein Support-Ticket aufzumachen. Das ist real. Ein Freifahrtschein ist es nicht.
Und dann gibt es noch einen zweiten Teil, den ich erst richtig verstanden habe, seit ich logge und überwache, was meine Agenten eigentlich tun. Ein Agent sieht alles, was er anfasst: die .env-Datei, die er liest, um einen Service zu debuggen, den API-Key in einer Konfiguration, die Kundenmail, die er zusammenfasst, das HR-Dokument, das er einsortiert. Mein eigenes Session-Archiv beweist es. Der Secret-Scanner über meine Agenten-Transkripte hat dieses Jahr 17 Credentials in 8 Sessions gefunden — Tokens von Anthropic, Hugging Face, Google und GitHub. Bei einem gehosteten Modell wandert jedes davon durch den Request-Pfad des Anbieters und, je nach dessen Aufbewahrungsrichtlinie, in seine Logs. Für Geschäftsarbeit mit personenbezogenen Daten, Mandantenakten oder allem, was der Verschwiegenheit unterliegt, ist das keine Datenschutz-Fußnote. Es ist ein Sicherheitsvorfall, der nur noch auf die Aufbewahrungsfrist wartet. Bei einem lokalen Modell verlässt das Transkript nie das Haus.
3. Du kannst reinschauen
Die Weights von GPT kannst du nicht lesen. Die von Llama schon.
Bei regulierter Arbeit trägt dieser Unterschied Last. Wenn die Rechtsabteilung eines Kunden wissen will, warum das System einen Antrag abgelehnt hat, ist „Das Modell hat es so gesagt" keine Antwort. Ein Modell, das dir gehört, kannst du inspizieren, loggen und sein Verhalten reproduzieren. Du kannst es per Fine-Tuning auf deine eigenen Dokumente anpassen, ohne sie irgendwohin zu schicken. Und du kannst es in einen 3B-Router destillieren, der pro Token ein Fünfzigstel kostet.
4. Das Ökosystem-Argument: langweilig, aber wahr
Wenn sich Weights herunterladen lassen, machen Leute Fine-Tuning darauf, bauen sie in Produkte ein, unterrichten damit, optimieren Hardware dafür und bauen Know-how auf, das jeden einzelnen Anbieter überlebt. Wenn nicht, konzentriert sich all das bei einer Handvoll Anbieter. Das ist kein Argument für offen statt geschlossen. Es ist ein Argument dafür, dass es beides gibt. Mir recht: Ich will einen Lieferanten, den niemand aufkaufen kann, und drei, die man aufkaufen kann.
Der unbequeme Teil: Nein, billiger ist das nicht
Ich enttäusche dich hier lieber, als dir ein Homelab zu verkaufen.
Eine API rechnet pro Token ab. Eine GPU kostet pro Stunde, egal ob sie arbeitet oder nicht. Self-Hosting rechnet sich nur, wenn du die GPU auslastest — und das schaffen die wenigsten Firmen.
Die Break-even-Analysen aus 2026 kommen alle beim selben Ergebnis an. Mietest du eine H100 für rund 3,50 $ pro GPU-Stunde und stellst sie einem Modell der DeepSeek-Klasse für etwa 3,50 $ pro Million Output-Token gegenüber, brauchst du größenordnungsmäßig eine Million Output-Token pro Stunde, bevor Self-Hosting günstiger wird. Ein offenes 27–70B-Modell gegen eine Frontier-API der Mittelklasse erreicht den Break-even bei rund 10–15 Millionen Token pro Tag. Darunter bezahlst du eine GPU fürs Rumstehen — und eine GPU im Leerlauf ist die teuerste Art, KI zu betreiben, die je erfunden wurde.
Und darunter liegst du öfter, als du denkst. Ein Cluster, der eine Firma montags bis freitags von 09:00 bis 18:00 bedient, ist 45 von 168 Wochenstunden im Einsatz — 27 %. Innerhalb dieses Fensters ist ein Verhältnis von Spitzen- zu Durchschnittslast von drei zu eins bei einem internen Tool völlig normal. Du dimensionierst also für die Spitze, oder du verwirfst um 11 Uhr Requests. Rechnest du beides ein, dreht sich die Rechnung um — und genau das finden all diese Analysen.
In meinem eigenen Lab kippt sie wieder zurück, und der Grund sind Agenten. Ein Mensch, der in ein Chatfenster tippt, lässt die GPU den Großteil der Stunde Däumchen drehen. Agenten nicht: Diesen Monat liefen bei mir bis zu sechs gleichzeitig. Genau damit füllen sich die Stunden, die ein Firmen-Cluster verschenkt. Wenn dein Workload agentisch ist und die Hardware schon auf deinem Schreibtisch steht, sieht das Auslastungsargument ganz anders aus.
Wenn es dir um Kosten geht, liegt der Hebel nicht in der Hardware, sondern im Routing. Per-Task-Routing im Stil von RouteLLM soll die Kosten um bis zu ~3,7× senken und dabei 95 % der Qualität halten, und rund 37 % der Unternehmen betreiben inzwischen fünf oder mehr Modelle. Billige Antworten auf einfache Fragen schlagen teure Hardware, immer.
Der ehrliche Pitch lautet also: Open Weights gewinnen bei Souveränität, Kontrolle und Beständigkeit. Bei den Kosten gewinnen sie nur in Ausnahmefällen. Wer das wegen des Preisschilds kauft, kauft das Falsche.
Wie Local Inference im Oktober 2026 tatsächlich aussieht
Unsere GPUs sind nicht schneller geworden. Die Architekturen sind sparse geworden, und die Hardware hat sehr viel Speicher bekommen.
MoE hat lokale Inference auf Frontier-Niveau möglich gemacht
Mixture-of-Experts heißt: Ein Modell mit insgesamt 300B+ Parametern aktiviert pro Token nur eine Handvoll Milliarden davon. Auf einer Kiste, die an der Memory-Bandwidth hängt, entscheidet genau das alles:
| Modelltyp | Gemessen auf derselben Hardware |
|---|---|
| Qwen3-30B-A3B (MoE) | ~89 tok/s |
| Qwen3-32B (dense, ähnliche Qualitätsklasse) | ~10,7 tok/s |
8,3× schneller, auf derselben Maschine, für dieselbe Aufgabe. Ein dichtes 27B-Modell braucht mit 4 Bit ~16–18 GB; ein MoE mit einer Billion Parametern ist laut Lizenz „offen", aber nicht „lokal" im Sinne von: läuft unter deinem Schreibtisch. Schau auf die aktiven Parameter, nicht auf die Zahl in der Schlagzeile.
Die Hardware: 128 GB auf dem Schreibtisch, für weniger als einen Gebrauchtwagen
| NVIDIA DGX Spark (GB10) | AMD Strix Halo (Ryzen AI Max+ 395) | Apple Mac Studio (M5 Ultra) | |
|---|---|---|---|
| Speicher | 128 GB unified | 128 GB unified | 128 GB+ unified |
| Bandwidth | ~273 GB/s | ~256 GB/s theoretisch, ~215 gemessen | ~1,2 TB/s |
| Preis | ~4.700 $ (Verfügbarkeit prüfen) | ~3.100 $ | deutlich über beiden |
| Runtime | CUDA, alles läuft unverändert | Vulkan/RADV + ROCm, llama.cpp & vLLM laufen | MLX / llama.cpp, exzellenter Decode |
| Stärke | Prefill bei langem Kontext, Clustering, FP4 | günstigster Einstieg mit 128 GB, x86-Flexibilität | reine Token-Generierung |
Zwei Kisten mit je 128 GB reichen für ein offenes MoE auf Frontier-Niveau. Zwei DGX Sparks über einen ConnectX-7-RoCE-Link liefern DeepSeek V4-Flash (284B, 1M Context Window) mit ~61 tok/s im Single-Stream; zwei Strix-Halo-Kisten auf dem ds4-Pfad kommen auf ~12–13 tok/s. Diese 4–5-fache Lücke kommt vom Interconnect und vom Speculative-Decoding-Stack, nicht von der Speichergeschwindigkeit.
Die wichtigste Zahl für alle, die Hardware kaufen wollen: Auf demselben MoE der 35B-Klasse landen beide Kisten mit ihrem besten Tuning bei ~97–100 tok/s, ohne Speculative Decoding bei ~70 vs. ~63 tok/s. Bei der Token-Generierung liegen die Maschinen praktisch gleichauf, weil beide an derselben Memory-Bandwidth hängen. Du kaufst die Kiste also nicht wegen Tokens pro Sekunde. Du kaufst sie wegen Prefill (auf der Spark 2–5× schneller, je länger der Kontext wird), wegen CUDA oder wegen des Preises.
Die Software: langweilig, ausgereift, OpenAI-kompatibel
Vier Schichten, die ständig miteinander verwechselt werden:
- llama.cpp — portable C++-Engine, beste Single-Stream-Latenz, GGUF-Quants, läuft auf CPU/AMD/Apple/Edge. Auf beiden Kisten meine Standard-Engine.
- vLLM / SGLang — GPU-first, Paged Attention, Continuous Batching, gebaut für viele gleichzeitige Nutzer. Ein Test von Red Hat auf einer einzelnen A100 hat für vLLM 793 tok/s gemessen, für Ollama mit Standardeinstellungen 41.
- Ollama / LM Studio — Komfort-Wrapper und Modell-Packaging. Perfekt für eine Person mit Laptop.
- Ein Proxy — llama-swap, NVIDIA Switchyard oder Ähnliches. Den Teil lassen die Leute weg und merken dann, dass sie keine drei Modelle auf einer GPU bedienen können.
Das spannende Engineering 2026 ist keine neue Engine, sondern Speculative Decoding: Ein kleines, billiges Draft-Modell schlägt mehrere Tokens vor, und das große Modell prüft sie in einem einzigen Durchlauf. Auf einer Kiste, die an der Bandwidth hängt, ist das nahezu geschenkter Durchsatz. Meine eigenen Messungen mit Qwen3.8-27B auf einer einzelnen DGX Spark: ~16–27 tok/s als Baseline, 34–51 tok/s mit SGLang + NVFP4 + Block Speculative Decoding. Das sind ~92 % der physikalischen Memory-Bandwidth-Grenze. Eine „schnellere Engine" gibt es nicht mehr zu kaufen; Luft nach oben bringt nur noch ein besseres Draft-Modell.
Die Fallen — für jede einzelne habe ich bezahlt:
-ngl 999 -fa on --no-mmap --jinjaist die Baseline, über die nicht verhandelt wird.- Was Speculative Decoding bringt, hängt vom Inhalt ab: Auf meiner Maschine sind es ~42–50 tok/s bei Mathe, ~26–41 bei englischem Code, ~16–18 bei Fließtext und ~12 bei Deutsch. Gleiches Modell, gleiche Kiste, andere Sprache. Ausgerechnet.
- Die Speicherverwaltung bei unified memory beißt dich.
--mem-fraction-static 0.95(ein Default aus dem Cookbook) hat stillschweigend das CUDA-Graph-Capture übersprungen und mich ~30 % gekostet, dazu einen harten Freeze. Im Betrieb fahre ich0.50mit einem Docker-Memory-Limit.
Was bei mir tatsächlich läuft
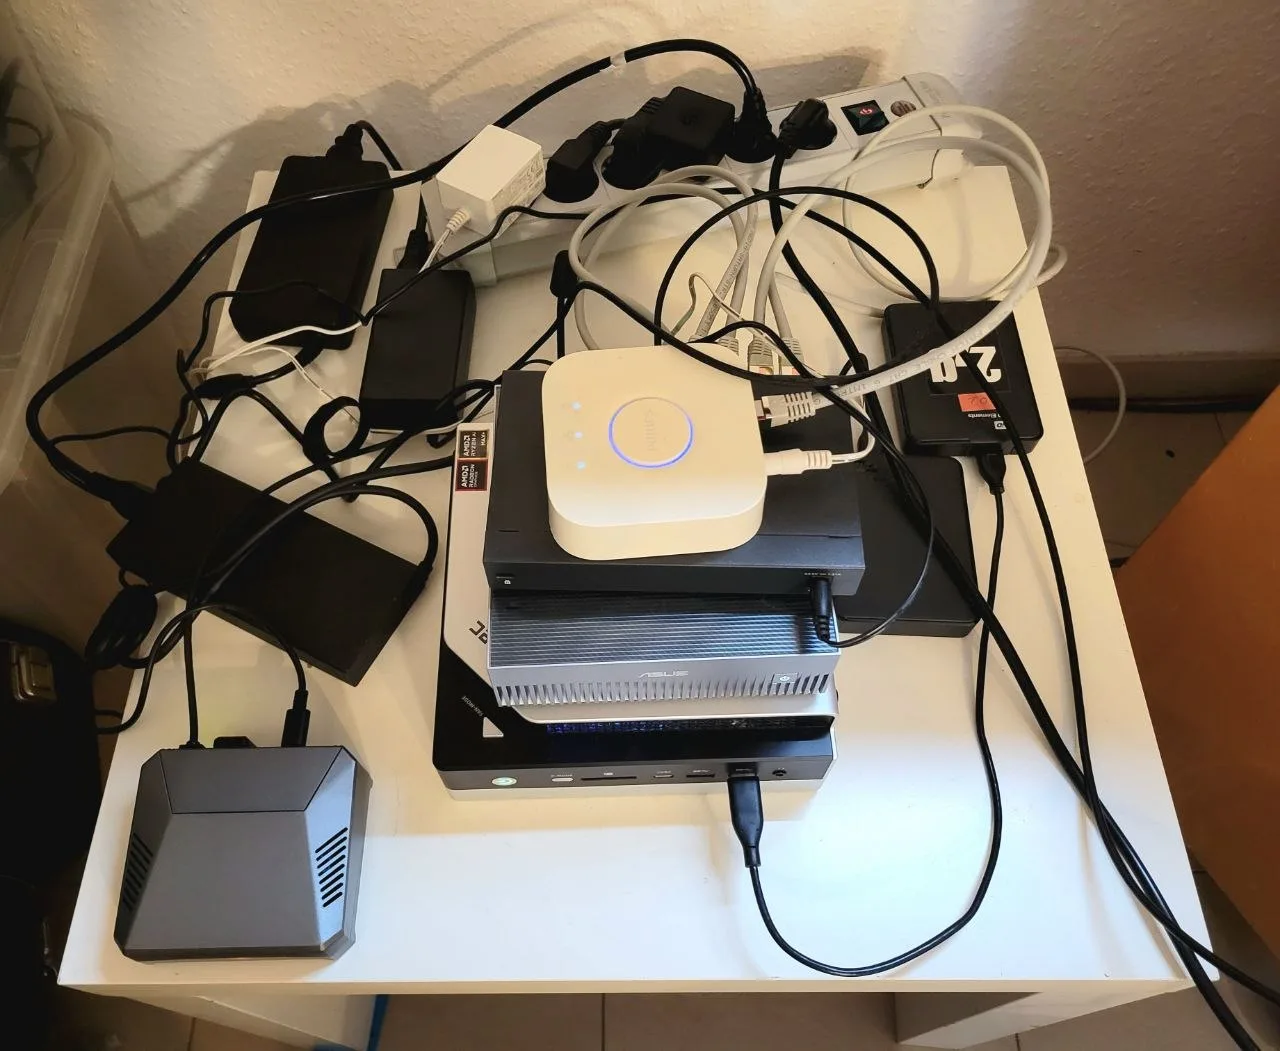
Zwei Maschinen in meinem Homelab, der denkfabrik, beide per YAML und mit einem einzigen Befehl provisioniert (das ist die kwisatz-Geschichte):
- Der AMD Strix Halo ist die zentrale Maschine des Labs. Neben seinem eigenen llama-swap hängen an ihm die Storage- und Backup-Platten, und er betreibt den Software-Stack, den eine Firma sonst mieten würde: Forgejo für Code, Open WebUI, Planka für Aufgaben, Prometheus und Grafana, Omnigent und einen Hermes-KI-Agenten, mit dem ich über Telegram rede.
- Die NVIDIA DGX Spark ist die Inference-Kiste: llama-swap als systemd-Service, Prometheus und Grafana daneben, und sonst nichts, was ihr die 128 GB streitig macht.
Das Lab gibt es aus demselben Grund wie diesen Artikel. Ich wollte wissen, ob eine kleine Firma ihre eigene KI und ihre eigenen Tools betreiben kann, ohne dass ein Hyperscaler im Datenpfad sitzt — und das probiere ich lieber an meinen eigenen Dokumenten aus als an denen eines Kunden.
| Baustelle | Was sie tut |
|---|---|
| Coding-Agent, Open WebUI, Kollegen und Familie | Fragen alle über denselben OpenAI-kompatiblen Endpoint. |
| llama-swap (Proxy, Port 9292) | Entscheidet pro Request, welche Engine antwortet, und tauscht Modelle im laufenden Betrieb. |
| llama.cpp | Die portable GGUF-Engine — läuft auf jeder der beiden Kisten. |
| TensorFold (DGX Spark), Gufo (Strix Halo) | Die Hardware-spezifischen Engine-Setups. |
| 128 GB unified memory | Alle Engines teilen sich denselben Speicher, die Weights liegen auf der Platte. |
| Prometheus + Grafana | Schorren die Engines. |
Der Kern des Inference-Setups ist ein Proxy, der Modelle im laufenden Betrieb austauscht — so teste ich fünf Modelle an einem Nachmittag, ohne mich irgendwo einloggen zu müssen.
Inzwischen stecken auch die getunten Rezepte in kwisatz. Je ein Task pro Kiste installiert Qwen3.8-27B und Qwen3.8 Flash Next (125B insgesamt, 5B aktiv — Stichwort aktive Parameter) auf der Engine, die zur Hardware passt: TensorFold auf der DGX Spark, Gufo auf dem Strix Halo. Jeder Task bringt sein Draft-Modell für Speculative Decoding, ein gepinntes Engine-Image und den Eintrag in llama-swap mit. Ein weiterer Task schützt genau vor dem Unified-Memory-Freeze aus den Fallen oben. Welche Engine antwortet, entscheidet der Modellname im Request.
Exotisch ist daran nichts mehr. Ein Ordner mit Weights, eine Engine, ein Proxy, eine UI und ein Dashboard.
Die Grenzen, ohne Schönfärberei
Jedes Argument oben für den eigenen Stack hat eine Kehrseite: Dir gehört dann auch seine Obergrenze — und seine Drecksarbeit.
- Die Obergrenze liegt tiefer. Die Frontier ist weiterhin geschlossen. Reasoning über lange Strecken, komplexe agentische Arbeit und die allerbeste Multimodalität liegen auf der anderen Seite der Linie. Wenn deine Arbeit davon abhängt, nimm die API — mache ich auch, für einen kleinen Teil meiner Arbeit.
- Skalierung ist dein Problem. Ein Nutzer mit 50 tok/s ist trivial, und eine Handvoll paralleler Agenten läuft auf meinen Kisten problemlos. Fünfzig Nutzer sind ein völlig anderes Problem, und eine einzelne Kiste löst es nicht.
- Sicherheit ist dein Problem. Die Security Advisories 2026 haben Ollama, vLLM und llama.cpp getroffen. Forscher haben 175.108 offen erreichbare Ollama-Hosts im öffentlichen Internet gezählt. Ein lokales Modell ohne Auth, ohne Firewall und ohne Update-Prozess ist keine „private KI", sondern ein Datenleck mit besserer Geschichte.
- Das Modell ist dein Problem. Nicht nur die GPU: Qualitätsverlust durch Quantization, Eval-Regressionen nach einem Checkpoint-Wechsel, das Verhalten des KV-Cache. Das ist jetzt deine Arbeit, und zwar echte Arbeit.
Nichts davon ist ein Grund, die Finger davon zu lassen. Es ist die Stellenbeschreibung — und der Grund, warum der Plan unten mit der API anfängt.
Was ich mit einem Firmenbudget daraus machen würde
Das Vorgehen, das sich bei mir bewährt hat:
- Fang mit der API an. Bring erst den Workflow in Ordnung. Solange du nicht weißt, welche Prompts tragend sind, kaufst du mit der Hardware nur eine sehr teure Ausbildung.
- Finde die drei Workloads, bei denen die Daten nicht raus dürfen — Verträge, HR, Support-Tickets, alles unter Verschwiegenheitspflicht oder Berufsgeheimnis. Das sind deine Kandidaten für lokal. Nicht „KI im Allgemeinen". Drei konkrete Workflows.
- Miss die Token pro Tag. Dann schau dir die Break-even-Zahl noch einmal an, denn deine wird nicht meiner entsprechen — und wenn du darunter liegst, heißt die Antwort: hybrid.
- Fahr hybrid. Die Frontier-API für die schwere, offene Arbeit; ein gepinntes Open-Weight-Modell hinter deinem eigenen Endpoint für die datensensiblen, volumenstarken, wiederkehrenden Aufgaben. Gleiche OpenAI-kompatible URL-Struktur, eine Konfigurationsänderung, um zwischen beiden zu wechseln — das ist der praktische Wert der Standard-API, und deshalb lässt sich mit dieser Architektur so billig experimentieren.
- Pinne und dokumentiere die Modellversion. Wenn sich deine Compliance-Story jedes Mal ändert, sobald ein Anbieter in seiner Webkonsole etwas umstellt, hast du keine Compliance-Story.
Wir brauchen Open Weights Models, weil sie die einzige Form von KI sind, bei der die Fehlerfälle mir gehören und nicht der Roadmap von jemand anderem. Das ist keine ideologische Haltung; es ist der Grund, warum ich ein System abnehmen kann, das die Dokumente meiner Kunden verarbeitet.
Die Weights liegen im Internet. Die Hardware kostet 3.000 $ und 5.000 $. Die Software ist ausgereift. Knapp ist eigentlich nur noch jemand, der das alles zusammensteckt — und genau darum geht es bei dem, was wir machen.
Demnächst hier im Blog: wie ich im Alltag mit KI-Agenten arbeite und welche Tools ich für das Tagesgeschäft und meine Workflows in der Softwareentwicklung nutze.
Quellen & Weiterlesen
| Aussage | Quelle |
|---|---|
| 5 Open-Weight-Releases in 3 Tagen (13.–16. Okt.) | AIToolCrunch, Oct 2026 |
| Muse Spark Open (816B/42B), 15. Okt. | Meta AI Research |
| Mistral Large 4, 1T/52B aktiv | Mistral |
| Open-Weight-Landschaft Apr.–Okt. 2026, Kolibri, Gemma 4, Qwen3.8-27B | Victor Grösser |
| DGX Spark vs. Strix Halo, gemessen | LLMRequirements |
| Unified memory / Bandwidth, 128-GB-Kisten | CanRun |
| vLLM vs. llama.cpp vs. Ollama: Abwägungen | Red Hat Developers, Slash-Digital |
| Break-even gegenüber Managed API | optinest, Helmcode, arXiv 2509.18101 |
| Auslastung, Leerlaufstunden | francisokafor.com |
| Warum Open Weights wichtig sind (Politik) | Brookings, Microsoft, Futurium (EU) |
| EU AI Act / DSGVO und Self-Hosting | Mickai, LLM Configurator, Lotus Libre |
| Scores im Intelligence Index v4.3.2 (abgerufen am 21. Okt. 2026) | Artificial Analysis |
| Routing-Ökonomie, 5+ Modelle pro Unternehmen | HBS Institute, Aug 2026 |
PS: Testet kwisatz und ihr bekommt wochenlange Vorarbeiten frei Haus auf eure Kiste :D