RAG ohne Frontier-Modelle: Warum gutes Retrieval wichtiger ist als das größte LLM
2026-06-24 · Manuel Spörer
RAG-Systeme werden oft auf das Sprachmodell reduziert. In Architekturdiagrammen steht dann links eine Vektordatenbank, rechts ein großes LLM und dazwischen ein Pfeil mit der Beschriftung "Kontext". Wenn die Antworten nicht gut genug sind, scheint die nächste Maßnahme naheliegend: ein größeres Modell, mehr Parameter, ein Frontier-Modell aus der Cloud.
In der Praxis liegt das Problem häufig an einer anderen Stelle. Das System hat den falschen Ausschnitt gefunden, eine Tabelle beim Einlesen zerstört, wichtige Begriffe durch unpassendes Chunking getrennt oder acht Treffer aus demselben Dokument in den Prompt gelegt. Ein stärkeres Sprachmodell kann diese Fehler sprachlich besser kaschieren. Die fehlende Evidenz kann es aber nicht zurückholen.
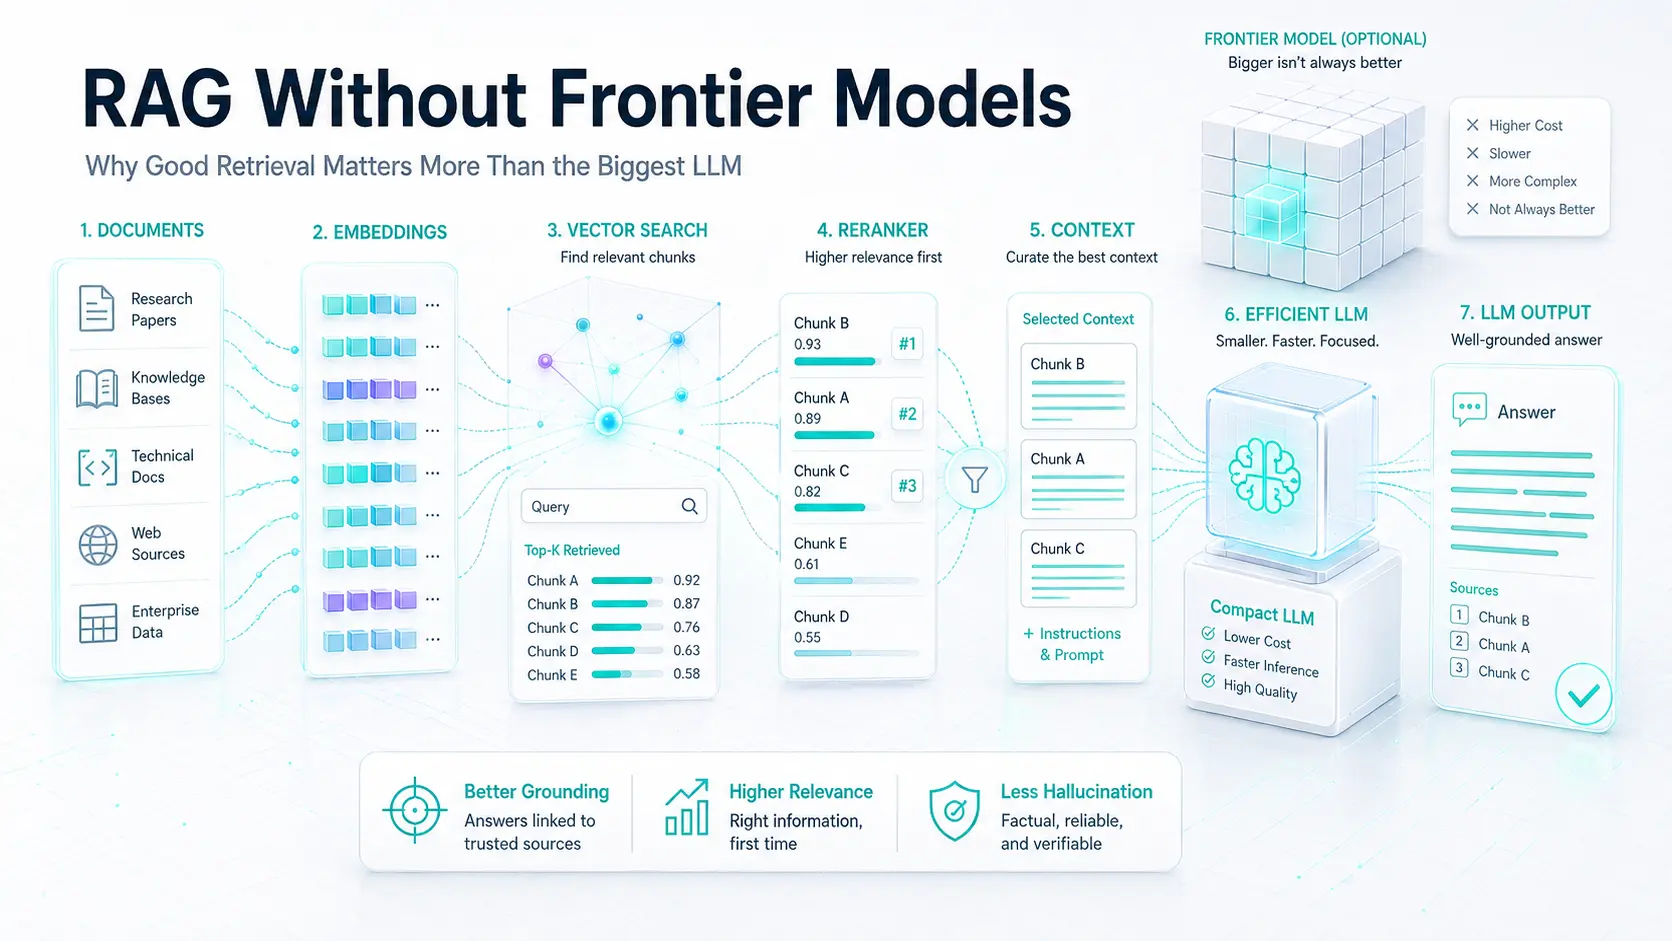
Genau deshalb ist unser RAG-Setup nicht um ein einzelnes möglichst großes Modell gebaut. Es ist eine Pipeline aus spezialisierten Modellen und deterministischen Schritten: Dokumente werden strukturerhaltend aufbereitet, tokenizer-genau zerlegt, mit zusätzlichem Kontext indexiert, hybrid gesucht, neu gerankt und erst danach an das Antwortmodell übergeben. Dieser Beitrag zeigt den Unterschied zwischen einem einfachen und einem Advanced-RAG-System, beschreibt unser aktuelles Setup und fasst die wichtigsten Dos und Don'ts aus der Umsetzung zusammen.
Was RAG eigentlich lösen soll
Retrieval-Augmented Generation, kurz RAG, kombiniert ein generatives Modell mit einer externen Wissensbasis. Statt eine Frage ausschließlich aus den Modellparametern zu beantworten, sucht das System zuerst passende Belegstellen und gibt sie zusammen mit der Frage an das LLM [1].
Das verändert die Aufgabe des Sprachmodells grundlegend. Es muss nicht das gesamte Fachwissen selbst gespeichert haben. Es soll einen kleinen, relevanten Kontext lesen, die Frage anhand dieses Kontexts beantworten und die verwendeten Quellen korrekt zuordnen. Fachwissen, Aktualität und Nachvollziehbarkeit liegen damit zu einem großen Teil außerhalb des Modells.
Das ist auch der Grund, warum die reine Modellgröße bei RAG weniger dominant ist als bei offenen Wissensfragen. Ein Frontier-Modell muss ohne Retrieval möglichst viele Fähigkeiten und Fakten in seinen Parametern vereinen. Ein RAG-Modell bekommt im Idealfall genau die acht Textstellen, die es für die konkrete Antwort braucht. Die schwierigste Frage lautet dann oft nicht "Kann das Modell diese Information wissen?", sondern "Hat unsere Pipeline die richtige Information gefunden und sauber präsentiert?"
Was ist ein Simple-RAG-System?
Ein einfaches RAG-System folgt meist einem überschaubaren Ablauf:
Dokumente -> Text extrahieren -> feste Chunks -> Embeddings -> Vektordatenbank

Frage -> Query-Embedding -> Top-k-Vektorsuche -> Chunks in den Prompt -> Antwort
Das ist ein sinnvoller Startpunkt. Ein solcher Aufbau ist schnell implementiert, leicht zu erklären und für kleine, homogene Dokumentbestände oft ausreichend. Er zeigt auch sofort, ob das Grundprinzip im eigenen Anwendungsfall funktioniert.
Simple RAG hat jedoch typische Grenzen. Eine reine Vektorsuche findet semantisch ähnliche Texte, kann aber bei exakten Produktnamen, Paragraphen, Abkürzungen oder Zahlen schlechter sein als eine klassische Stichwortsuche. Starres Chunking trennt Tabellen von ihren Überschriften oder Aussagen von dem Abschnitt, der ihnen Bedeutung gibt. Ein flaches Top-k kann außerdem fast vollständig aus einem einzigen langen PDF bestehen. Das Antwortmodell erhält dann zwar formal Kontext, aber keinen guten Kontext.
Die RAG-Forschung unterscheidet deshalb häufig zwischen Naive, Advanced und Modular RAG [2]. Entscheidend ist dabei nicht das Label. Entscheidend ist, an welchen Stellen der Pipeline Qualität verloren geht und welche Gegenmaßnahmen dort tatsächlich helfen.
Was macht unser System zu Advanced RAG?
Unser Query-Pfad besteht heute aus vier zentralen Retrieval-Schritten und einem separaten Generationsschritt:
Frage
  -> BGE-M3 Query-Embedding
  -> Weaviate Hybrid Search: BM25 + drei Vektorräume
  -> Dokument-Gruppierung: bis zu 12 Dokumente x 4 Chunks
  -> BGE-Reranker-v2-M3: etwa 48 Kandidaten auf Top 8
  -> finaler Dokument-Cap: höchstens 3 Chunks je Dokument
  -> Qwen3-30B-A3B erzeugt die Antwort mit Quellenmarkern
Jeder dieser Schritte löst ein anderes Problem. Das Embedding-Modell sorgt für semantische Suche. BM25 fängt exakte Begriffe und seltene Wörter ab. Der Cross-Encoder bewertet Frage und Textstelle gemeinsam. Die Dokument-Caps verhindern, dass eine einzige umfangreiche Quelle den gesamten Kontext belegt. Das generative Modell sieht am Ende nur einen kleinen, bereits kuratierten Evidenzraum.
1. Struktur kommt vor Embedding
HTML, Markdown und PDF laufen bei uns nicht einfach durch denselben Text-Splitter. Webseiten werden über ihre lesbaren Inhalte aufbereitet. PDF-Seiten werden mit granite-docling-258M in DocTags und anschließend in ein strukturiertes Docling-Dokument überführt. Docling unterstützt dafür eine VLM-Pipeline, die Seitenbilder in strukturierte Dokumentrepräsentationen umwandelt [8, 9].
Danach zerlegt ein HybridChunker die Dokumente. Der Tokenizer ist auf BGE-M3 gepinnt, also auf genau das Modell, das später die Chunks einbettet. Unser aktueller Grenzwert liegt bei 512 Tokens. Überschriftenpfade, Abschnitts-IDs und bei PDF-Dokumenten Seitenzahlen bleiben als Metadaten erhalten.
Das klingt nach einem Detail, ist aber eine der wichtigsten Architekturentscheidungen. Wer mit einem beliebigen Zeichengrenzwert chunkt und später mit einem anderen Tokenizer arbeitet, misst zwei verschiedene Dinge. Wer die Dokumentstruktur vorher flachklopft, kann sie nach dem Embedding nicht mehr rekonstruieren.
2. Contextual Retrieval gegen isolierte Chunks
Ein einzelner Chunk ist häufig mehrdeutig. Ein Satz wie "Der Anspruch besteht für maximal 78 Wochen" ist ohne Dokumenttitel und Abschnitt kaum auffindbar. Geht es um Krankengeld, Kinderkrankengeld oder eine andere Leistung?
Deshalb erzeugt unser System beim Ingest für jeden nicht degenerierten Chunk einen kurzen Kontext-Prefix. Das Modell sieht dabei den Dokumentkopf, den umgebenden Abschnitt und den eigentlichen Chunk. Der erzeugte Prefix umfasst ein bis drei Sätze und wird vor den Chunk gestellt, bevor sowohl das Embedding als auch der BM25-Index entstehen. Der rohe Inhalt bleibt separat erhalten.
Dieses Verfahren orientiert sich an Contextual Retrieval. Anthropic beschreibt dabei genau die Kombination aus kontextualisierten Embeddings und kontextualisiertem BM25 [3]. Wichtig ist der Zeitpunkt: Der zusätzliche Kontext muss vor der Indexierung entstehen. Ihn erst nach dem Retrieval anzuhängen verbessert die Suche nicht mehr.
In unserem System bekommt der Context-Pass nicht das vollständige Dokument für jeden Chunk. Stattdessen nutzen wir Dokumentkopf und Abschnitt, bei sehr langen Abschnitten ein Fenster um den aktuellen Chunk. Das begrenzt Kosten und Kontextgröße. Die Aufrufe laufen sequenziell, damit der Prefix-Cache von llama.cpp wiederverwendet werden kann.
3. Drei Vektoren statt ein Einheits-Embedding
Jeder Chunk erhält bei uns drei BGE-M3-Vektoren:
| Vektor | Inhalt | Zweck |
|---|---|---|
content_vector | Kontext-Prefix plus Chunk-Text | semantische Relevanz der Passage |
title_vector | Überschriftenpfad oder Dokumenttitel | thematische und strukturelle Einordnung |
description_vector | Dokumentbeschreibung | Dokumentebene und grober Inhalt |
BGE-M3 ist multilingual, unterstützt lange Eingaben und wurde für mehrere Retrieval-Arten entwickelt. Die Model Card empfiehlt für RAG ausdrücklich die Kombination aus hybrider Suche und Reranking [4]. In unserem Aufbau nutzen wir das Modell für dichte Vektoren und kombinieren diese mit dem BM25-Index von Weaviate.
Weaviate selbst erzeugt dabei keine Embeddings. Die Collection verwendet selbst bereitgestellte Vektoren. Das hält die Modellwahl in unseren Services, macht Re-Indexierungen reproduzierbarer und verhindert, dass Datenbankkonfiguration und Modell-Lifecycle unnötig aneinander gekoppelt sind. Weaviate empfiehlt bei eigenen Embedding-Modellen ebenfalls, die automatische Vektorisierung zu deaktivieren [6].
4. Hybrid Search statt Vector Search only
Die Suche läuft gleichzeitig über BM25 und die drei Vektorräume. Weaviate fusioniert beide Ergebnislisten; der Parameter alpha steuert dabei den Anteil der Vektorsuche [6]. Unser Startwert ist 0.3, die Stichwortseite erhält also bewusst mehr Gewicht als die semantische Seite.
Das ist keine allgemeingültige Best Practice. Es ist ein Startwert für unseren deutschsprachigen Korpus mit vielen Fachbegriffen, Leistungsnamen, Jahreszahlen und gesetzlichen Formulierungen. Gerade dort sind exakte Tokens wertvoll. Eine Frage nach einem bestimmten Paragraphen sollte nicht verlieren, nur weil ein anderer Text semantisch ähnlicher klingt.
Wichtig ist auch, dass Filter vor dem Scoring greifen. Quellen, einzelne URLs und Tags begrenzen den Suchraum, bevor die Treffer bewertet werden. Ein nachträgliches Wegfiltern würde relevante Kandidaten verdrängen, die außerhalb des zuerst geladenen Top-k liegen.
5. Reranking und Quellenvielfalt
Die hybride Suche ist schnell und breit, aber noch nicht präzise genug für den finalen Prompt. Deshalb liest bge-reranker-v2-m3 die Frage und jeden Kandidaten gemeinsam. Anders als ein Bi-Encoder erzeugt der Cross-Encoder keine voneinander unabhängigen Vektoren, sondern bewertet das Textpaar direkt. Das ist genauer, aber teurer und eignet sich deshalb für einige Dutzend Kandidaten statt für den gesamten Index [5].
Vor dem Reranker gruppiert Weaviate die Ergebnisse nach Dokument. Standardmäßig laden wir bis zu 12 Dokumentgruppen mit jeweils maximal vier Chunks, also ungefähr 48 Kandidaten. Nach dem Reranking bleiben acht Chunks übrig. Ein zweiter Cap begrenzt den finalen Kontext auf höchstens drei Chunks pro Dokument.
Die zwei Stufen sind notwendig. Eine Gruppierung erst nach einem flachen Top-30 würde nicht helfen, wenn die ersten 25 Treffer bereits aus demselben PDF stammen. Die verdrängten Treffer anderer Dokumente wurden dann nie geladen. Umgekehrt kann der Reranker trotz diverser Kandidaten wieder mehrere Passagen derselben Quelle nach oben sortieren. Deshalb folgt der zweite Cap nach dem Reranking.
Für dokumentbezogene Fragen wird diese Regel gelockert. Wenn der Scope ausschließlich aus höchstens drei konkreten URLs besteht, suchen wir tiefer innerhalb dieser Dokumente. Advanced RAG bedeutet nicht, jede Heuristik immer anzuwenden. Es bedeutet auch, sie passend zum Fragetyp kontrolliert auszusetzen.
6. Ein begrenzter Job für das Antwortmodell
Erst jetzt kommt das generative Modell ins Spiel. Der Kontext wird nach Dokument und Abschnitt gruppiert, innerhalb eines Dokuments wieder in Lesereihenfolge gebracht und mit Titel, URL, Überschriftenpfad und Seitenangaben versehen. Das System-Prompt erlaubt ausschließlich Antworten aus diesem Kontext und verlangt Quellenmarker im Format [N]. Reicht die Evidenz nicht aus, soll das Modell genau das sagen.
Das aktuelle Antwortmodell ist Qwen3-30B-A3B-Instruct-2507 als quantisierte GGUF-Variante. Es ist ein Mixture-of-Experts-Modell mit 30,5 Milliarden Gesamtparametern, von denen pro Token nur etwa 3,3 Milliarden aktiviert werden [7]. Für die Aufgabe "acht relevante Belegstellen lesen, auf Deutsch zusammenfassen und korrekt zitieren" ist das ein deutlich engerer Arbeitsauftrag als offene Recherche oder allgemeines Problemlosen.
Welche Modelle wir konkret einsetzen
Unser Setup ist kein Ein-Modell-System. Die Modelle sind nach Aufgabe aufgeteilt:
| Modell | Größe bzw. Variante | Aufgabe im System |
|---|---|---|
bge-m3 | GGUF F16, rund 0,6B Parameter | Query-, Inhalts-, Titel- und Beschreibungs-Embeddings |
bge-reranker-v2-m3 | GGUF Q8, rund 0,6B Parameter | Cross-Encoder-Reranking der Suchkandidaten |
Qwen3-30B-A3B-Instruct-2507 | GGUF Q5_K_M, 30,5B gesamt / 3,3B aktiv | Antwortgenerierung im aktuellen Text-RAG-Pfad |
Qwen3-VL-30B-A3B-Instruct | lokal über llama.cpp | Kontext-Prefixes, Tags und Dokumentköpfe; perspektivisch auch multimodale Antworten |
granite-docling-258M | 258M, VLM | strukturierte PDF-Konvertierung in DocTags |
Alle GPU-gebundenen Modellaufrufe laufen über eine OpenAI-kompatible Schnittstelle. llama.cpp serviert die GGUF-Modelle; llama-swap liegt als Router davor und kann Modelle bedarfsgerecht laden und tauschen [10, 11]. Das Serving läuft getrennt vom Docker-Anwendungsstack auf unserer Infrastruktur. Kleine Embedding- und Reranking-Modelle können resident bleiben, während größere generative Modelle bei Bedarf geladen werden.
Warum wir dafür kein Frontier-Modell brauchen
Die kurze Antwort lautet: Weil das generative Modell in diesem System nicht die ganze Arbeit erledigt.
Ein Frontier-Modell wäre zweifellos stärker bei offenem Schlussfolgern, mehrdeutigen Aufgaben, breiter Weltkenntnis und sehr komplexer Synthese. Unser Standard-RAG-Pfad schneidet diese Aufgabe jedoch bewusst kleiner. Die Wissensauswahl übernehmen Retrieval und Reranker. Die Dokumentstruktur entsteht im Ingest. Quellenvielfalt wird deterministisch erzwungen. Die Zitatnummern kommen aus einer festen Zuordnung. Das Antwortmodell muss den gelieferten Kontext verlässlich verarbeiten, nicht das Internet aus seinen Parametern rekonstruieren.
Daraus ergeben sich vier praktische Vorteile:
- Daten bleiben unter eigener Kontrolle. Dokumente und Prompts müssen nicht für jeden Request an einen externen Modellanbieter gesendet werden.
- Kosten werden planbarer. Nach der Hardware-Investition entstehen keine tokenbasierten API-Kosten pro Anfrage oder pro Re-Indexierung. Strom, Betrieb und Wartung verschwinden dadurch natürlich nicht.
- Modelle bleiben austauschbar. Embedding, Reranking und Generation sind über klar definierte Schnittstellen getrennt. Ein neues Antwortmodell erfordert keinen Wechsel der Vektordatenbank.
- Fehler werden lokalisierbar. Ein schlechter Treffer ist ein Retrieval-Problem. Eine falsche Sortierung ist ein Reranking-Problem. Eine unbelegte Formulierung ist ein Generations- oder Prompt-Problem. In einem monolithischen "großes Modell macht alles"-Aufbau verschwimmen diese Ebenen.
Die Aussage lautet deshalb nicht, dass kleine Modelle grundsätzlich besser als Frontier-Modelle sind. Sie lautet: Für eine klar begrenzte, evidenzbasierte RAG-Aufgabe ist ein Frontier-Modell nicht automatisch der wirksamste oder wirtschaftlichste Hebel.
Lessons Learned: Was in der Praxis wirklich zählt
Retrieval-Fehler schlagen Generationsfehler
Wenn die richtige Passage nicht im Kontext steht, kann das Antwortmodell nur ablehnen oder raten. Ein Modellwechsel verbessert dann oft den Stil, aber nicht die Faktenbasis. Deshalb debuggen wir Fragen rückwärts: Welche Chunks sah das Modell? Welche Kandidaten sah der Reranker? Was lieferte die hybride Suche? Was wurde ursprünglich indexiert?
Chunking ist Teil des Modellsystems
Chunk-Größe, Tokenizer, Tabellenbehandlung, Überschriften und Seitenzuordnung entscheiden mit darüber, welche Information später auffindbar ist. Chunking ist keine kosmetische Vorverarbeitung. Es ist ein zentraler Bestandteil des Retrieval-Designs.
Mehr Treffer sind nicht automatisch mehr Kontext
Ein größeres Top-k kann die Antwort verschlechtern. Ähnliche oder redundante Passagen konkurrieren um Aufmerksamkeit, lange Dokumente dominieren den Prompt und die Zitatzuordnung wird unübersichtlicher. Unser zweistufiger Dokument-Cap war deshalb wichtiger als eine weitere Erhöhung des Kontextfensters.
Degradation darf funktionieren, aber nicht unsichtbar sein
Fällt der Reranker aus, antwortet das System mit der Reihenfolge der hybriden Suche weiter, statt jede Anfrage mit HTTP 500 abzubrechen. Der Zustand wird als degraded markiert und geloggt. Eine verbleibende Lücke ist, dass das Frontend dieses Flag derzeit noch nicht für Endnutzer anzeigt. Fail-soft ist richtig, stiller Qualitätsverlust nicht.
Modell-Serving ist ein eigenes Architekturthema
Contextual Retrieval erzeugt viele ähnliche Prompts. Ohne Prefix-Cache musste unser Modell denselben Dokumentkontext für jeden Chunk erneut verarbeiten. Mit Cache-Reuse und getrennten parallelen Slots für Ingest und Chat sinkt die Prefill-Arbeit deutlich. Die Wahl des Modells allein sagt wenig über den realen Durchsatz aus; Cache, Parallelität, Quantisierung und Swap-Verhalten sind mindestens ebenso relevant.
Ein "Advanced"-System braucht nicht jedes Advanced-Feature
Wir verwenden derzeit bewusst kein Query-Rewriting für Folgefragen. Die letzte Nutzernachricht geht direkt ins Retrieval. Das hat eine bekannte Grenze bei fragmentarischen Fragen wie "Und was kostet das?", vermeidet aber auch einen weiteren generativen Schritt, der die Suchintention verändern kann. Wenn Messdaten zeigen, dass diese Grenze relevant ist, gibt es einen klaren Einhängepunkt. Bis dahin bleibt die Pipeline einfacher.
Ohne Evaluation bleibt auch eine gute Architektur eine Hypothese
Die aktuellen Werte, 512 Tokens pro Chunk, alpha = 0.3, 12 mal 4 Kandidaten, Top 8 und maximal drei finale Chunks je Dokument, sind begründete Startwerte. Sie sind noch nicht gegen ein vollständiges Golden Set kalibriert. Auch der geplante Vergleich zwischen Qwen3-30B und Qwen3-VL für Textantworten steht noch aus.
Damit ist dieser Beitrag ein belastbarer Architektur- und Erfahrungsbericht, aber kein wissenschaftlicher Nachweis, dass unser lokales Modell jedes Frontier-Modell schlägt. Die korrekte nächste Stufe ist nicht ein größeres Modell auf Verdacht, sondern eine reproduzierbare Evaluation von Retrieval-Treffern, Antworttreue, Zitaten, Latenz und Kosten.
Dos und Don'ts für RAG-Systeme
| Do | Don't |
|---|---|
| Retrieval und Generation getrennt messen | Antwortqualität nur nach Sprachstil beurteilen |
| Chunking am Tokenizer des Embedding-Modells ausrichten | Dokumente blind nach Zeichen oder Absätzen teilen |
| BM25 und Vektorsuche kombinieren | Sich ausschließlich auf semantische Ähnlichkeit verlassen |
| Einen spezialisierten Reranker für einen begrenzten Kandidatenpool einsetzen | Einen Cross-Encoder über den gesamten Index laufen lassen |
| Quellenvielfalt vor und nach dem Reranking absichern | Ein langes Dokument den gesamten Kontext fluten lassen |
| Kontext-Prefixes vor Embedding und BM25 erzeugen | Kontext erst nach dem Retrieval ankleben |
| Rohtext, Suchtext und Metadaten getrennt speichern | Generierten Kontext unwiderruflich in den Originaltext mischen |
| Filter vor dem Scoring anwenden | Erst Top-k laden und unpassende Treffer danach entfernen |
| Ausfälle sichtbar degradieren und zählen | Qualitätsverluste still verschlucken |
| Modelle hinter stabilen Schnittstellen austauschbar halten | Datenbank, Framework und Modell-Lifecycle hart koppeln |
| Mit einem Golden Set Retrieval und Antwort getrennt evaluieren | Modellgröße als Ersatz für Messung verwenden |
Wann ein Frontier-Modell trotzdem sinnvoll ist
Es gibt Aufgaben, bei denen wir ein Frontier-Modell weiterhin ernsthaft prüfen würden: offene Recherche über viele unbekannte Quellen, sehr komplexe mehrstufige Schlussfolgerungen, anspruchsvolle Agentenplanung, schwach strukturierte Anfragen mit hoher Mehrdeutigkeit oder eine Qualitäts-Baseline für die Evaluation lokaler Modelle.
Auch ein schlechter oder unvollständiger Korpus kann den Modellbedarf verschieben. Wenn die Antwort nicht explizit in den Dokumenten steht und aus vielen verstreuten Hinweisen abgeleitet werden muss, wird die Synthesefähigkeit des LLM wichtiger. Das ist dann aber eine bewusste Produkteigenschaft, kein Grund, jeden Standard-RAG-Request vorsorglich an das größte verfügbare Modell zu senden.
Gerade in fachlichen und regulierten Domänen bleibt zudem eine klare Grenze: Weder lokales Modell noch Frontier-Modell ersetzt fachliche Validierung, gute Quellen und systematische Evaluation. Ein größeres Modell ist kein Compliance-Mechanismus.
Fazit: Das beste RAG-Modell ist eine gute Pipeline
Bei RAG entscheidet nicht ein einzelnes Modell über die Qualität. Entscheidend ist das Zusammenspiel aus Dokumentverarbeitung, Chunking, Embeddings, Suchverfahren, Reranking, Kontextaufbau und Generation.
Unser Setup nutzt deshalb mehrere spezialisierte Open-Weight-Modelle statt eines Frontier-Modells für alles. BGE-M3 macht Texte auffindbar. BGE-Reranker-v2-M3 sortiert Kandidaten präziser. Granite Docling erhält die Struktur von PDF-Seiten. Qwen3 erzeugt aus wenigen, ausgewählten Belegen eine deutschsprachige Antwort mit Quellen. Weaviate, llama.cpp und llama-swap halten die Komponenten technisch getrennt und lokal betreibbar.
Der entscheidende Punkt ist nicht, dass 30 Milliarden Parameter immer genügen. Der Punkt ist, dass ein gut gebautes RAG-System dem Modell eine Aufgabe gibt, für die sie genügen können. Bevor man also das nächste Frontier-Modell einkauft, sollte man prüfen, ob das aktuelle System überhaupt die richtigen acht Textstellen findet.
Quellen
[1] Lewis et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. 2020.
[2] Gao et al. Retrieval-Augmented Generation for Large Language Models: A Survey. 2023.
[3] Anthropic. Introducing Contextual Retrieval. 2024.
[4] Beijing Academy of Artificial Intelligence. BGE-M3 Model Card.
[5] Beijing Academy of Artificial Intelligence. BGE Reranker v2 M3 Model Card.
[6] Weaviate. Hybrid Search und Bring Your Own Vectors.
[7] Qwen Team. Qwen3-30B-A3B-Instruct-2507 Model Card.
[8] Docling. Vision Models.
[9] IBM Granite. granite-docling-258M Model Card.
[10] ggml-org. llama.cpp.
[11] mostlygeek. llama-swap.