Neuronale Netze einfach erklärt: Wie Maschinen aus Beispielen lernen
2026-04-26 · Manuel Spörer
Es beginnt nicht mit Bewusstsein. Es beginnt mit einem Fehler.
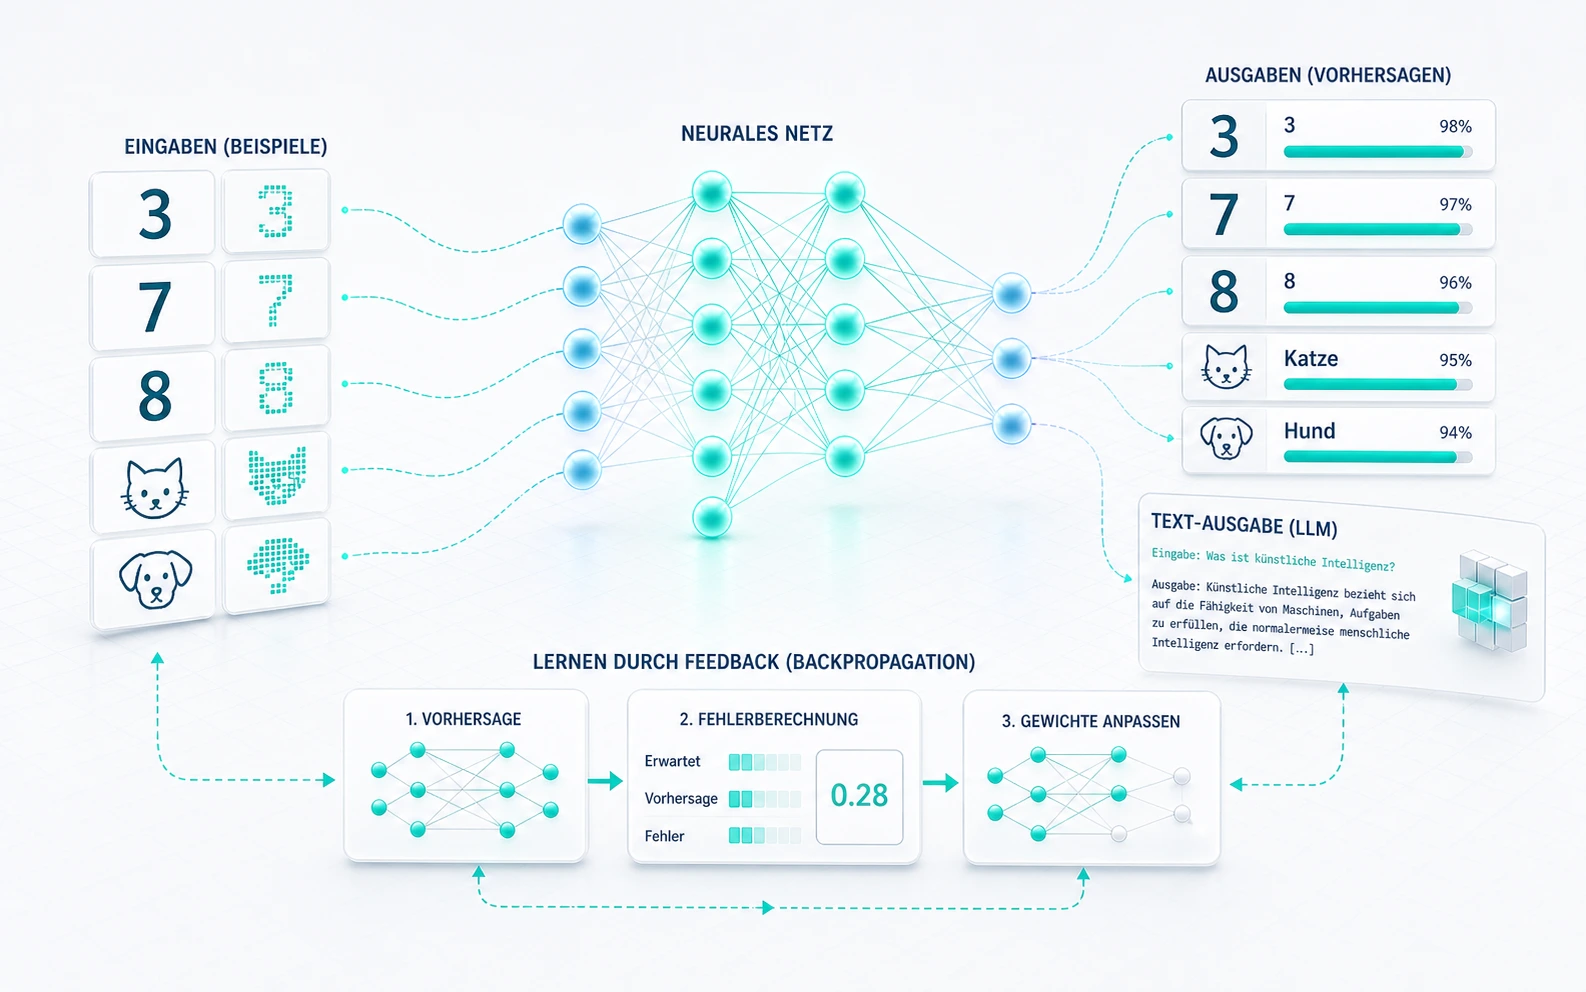
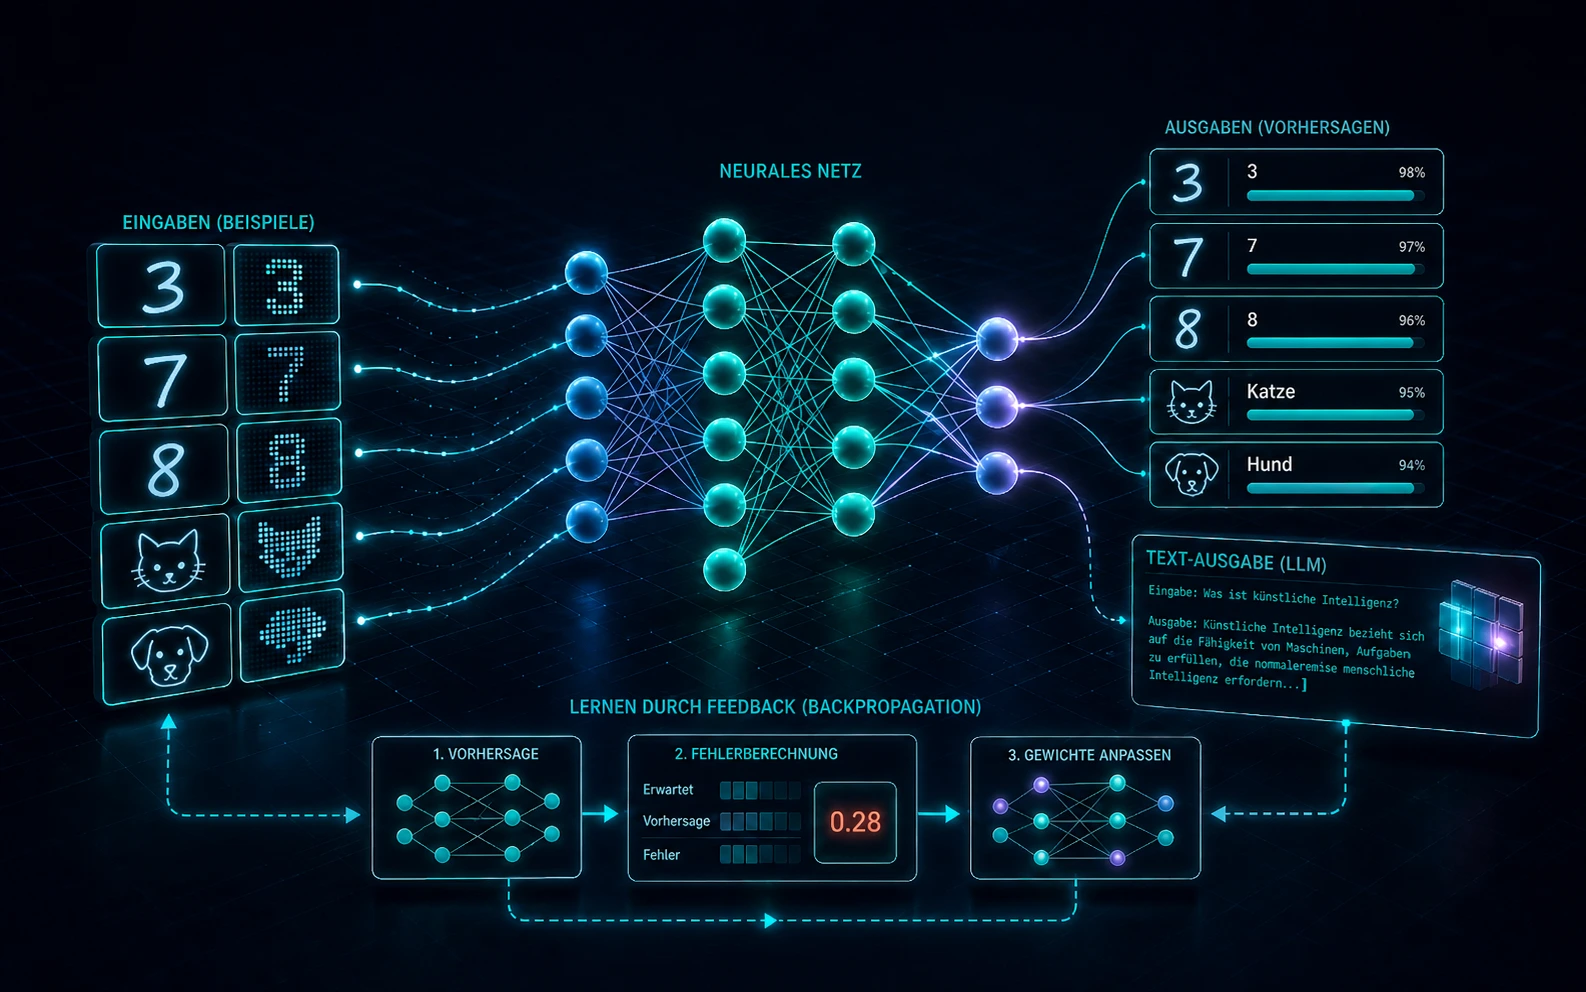
Eine Maschine soll handgeschriebene Ziffern erkennen. Sie sieht ein Bild, sagt „8", obwohl dort eine „3" steht, und bekommt zurückgemeldet: falsch. Beim nächsten Versuch verändert sie winzige Stellschrauben in ihrem Inneren. Nicht viel. Nur gerade genug, um beim nächsten Bild vielleicht ein kleines bisschen besser zu liegen.
Genau aus dieser unscheinbaren Schleife entsteht der Kern moderner KI: Beispiel sehen, Vorhersage machen, Fehler messen, Gewichte anpassen. Wieder und wieder. Aus vielen kleinen Korrekturen wird ein System, das Muster erkennt, die niemand einzeln programmiert hat.
Neuronale Netze wirken heute oft wie eine Technologie aus dem Nichts. Chatbots schreiben Texte, Bildmodelle erzeugen Motive, Empfehlungssysteme sortieren Feeds, Assistenzsysteme erkennen Sprache. Unter der Oberfläche steckt aber eine klare Idee, die deutlich älter ist als der aktuelle KI-Boom: Maschinen können Muster aus Beispielen lernen, statt ausschließlich handgeschriebene Regeln auszuführen [1, 3].
Dieser Beitrag ist der thematische Einstieg. Er erklärt, was ein neuronales Netz ist, wie Training funktioniert, warum „Lernen" nicht dasselbe ist wie Verstehen und weshalb diese Grundidee bis zu modernen LLMs führt.
Was ist ein neuronales Netz?
Ein neuronales Netz ist ein mathematisches Modell, das Eingaben in Ausgaben verwandelt. Ein Bild wird zu einer Klasse. Ein Satzanfang wird zu einem nächsten Wort. Ein Signal wird zu einer Entscheidung. Der Name erinnert an biologische Nervenzellen, aber die technische Realität ist nüchterner: Es geht um Zahlen, Gewichte, Aktivierungsfunktionen und sehr viele Rechenschritte [3, 4].
Die Grundidee ist einfach. Ein künstliches Neuron erhält mehrere Eingaben. Jede Eingabe bekommt ein Gewicht. Danach werden die gewichteten Werte addiert und durch eine Aktivierungsfunktion geschickt. Diese nichtlineare Aktivierung ist wichtig, weil neuronale Netze dadurch komplexere Zusammenhänge lernen können als rein lineare Modelle [4].
Allein ist ein solches Neuron noch kein Wunderwerk. Interessant wird es erst, wenn viele Neuronen in Schichten verbunden werden. Dann kann ein Netz einfache Muster in frühen Schichten erkennen und sie in späteren Schichten zu komplexeren Strukturen kombinieren.
Wie lernen neuronale Netze aus Beispielen?
Der wichtigste Unterschied zu klassischer Software liegt im Training. Bei klassischer Programmierung schreibt ein Mensch Regeln: Wenn dies passiert, tue das. Bei neuronalen Netzen gibt man dem System Beispiele und lässt es die passenden inneren Einstellungen selbst finden. Diese Idee steht bereits hinter frühen Lernmodellen wie Rosenblatts Perzeptron [1].
Ein einfaches Beispiel: Ein Modell soll zwischen Katzen- und Hundebildern unterscheiden. Am Anfang sind seine Gewichte zufällig. Es rät, liegt oft falsch und bekommt für jedes Bild eine Rückmeldung. Diese Rückmeldung wird in einen Fehlerwert übersetzt. Danach verändert das Modell seine Gewichte so, dass der Fehler beim nächsten Mal kleiner werden soll.
Das ist keine Intuition. Es ist Optimierung. Das Netz sucht in einem riesigen Raum möglicher Einstellungen nach einer Konfiguration, die gute Vorhersagen liefert.
Training in einem Satz
Ein neuronales Netz lernt, indem es seine Ausgaben mit den richtigen Antworten vergleicht und seine Gewichte so anpasst, dass der Fehler über viele Beispiele hinweg kleiner wird [2, 4].
Diese Form des Lernens ist der Grund, warum neuronale Netze bei Aufgaben stark sind, für die Menschen schwer exakte Regeln formulieren können. Wie beschreibt man alle möglichen Varianten einer handgeschriebenen „7"? Wie formuliert man eine vollständige Regel für „sieht aus wie ein Hund"? Solche Muster sind oft leichter zu zeigen als zu programmieren.
Warum Gewichte die eigentliche Erinnerung des Modells sind
Wenn ein neuronales Netz trainiert wurde, steckt sein „Wissen" nicht in einer Liste einzelner Beispiele. Es liegt verteilt in den Gewichten. Diese Gewichte bestimmen, welche Signale verstärkt, abgeschwächt oder kombiniert werden [3, 4].
Das ist wichtig, weil es einen verbreiteten Denkfehler korrigiert: Ein trainiertes KI-Modell ist nicht einfach eine Datenbank. Es schlägt nicht mechanisch nach, welches Bild oder welcher Satz im Training vorkam. Es berechnet aus einer Eingabe eine Ausgabe, basierend auf Mustern, die in den Gewichten gespeichert sind.
Natürlich können große Modelle einzelne Trainingsinhalte manchmal reproduzieren, besonders wenn Daten mehrfach oder schlecht gefiltert vorkommen. Das Grundprinzip bleibt aber ein anderes als bei einer Suchmaschine. Ein neuronales Netz erinnert nicht wie ein Archiv. Es generalisiert über Beispiele [4, 8].
Backpropagation: Wie der Fehler rückwärts durch das Netz wandert
Damit ein Netz besser wird, muss es wissen, welche Gewichte zum Fehler beigetragen haben. Genau hier kommt Backpropagation ins Spiel. Das Verfahren wurde in den 1980er-Jahren zu einem zentralen Baustein moderner neuronaler Netze [2].
Vereinfacht läuft es so ab: Das Netz macht eine Vorhersage. Eine Verlustfunktion misst, wie weit diese Vorhersage vom gewünschten Ergebnis entfernt ist. Dann wird dieser Fehler rückwärts durch die Schichten verteilt. Für jedes Gewicht wird berechnet, in welche Richtung es leicht verändert werden sollte. Anschließend aktualisiert ein Optimierungsverfahren die Gewichte [2, 4].
Der einzelne Schritt ist klein. Die Wirkung entsteht durch Wiederholung. Moderne Modelle durchlaufen riesige Datenmengen, oft über sehr viele Trainingsschritte hinweg. Lernen ist hier kein Moment der Einsicht, sondern eine lange Kette winziger Korrekturen.
Warum tiefe neuronale Netze plötzlich so mächtig wurden
Die Idee neuronaler Netze ist älter als der aktuelle KI-Hype. Schon frühe Modelle wie das Perzeptron zeigten, dass Maschinen einfache Muster aus Beispielen lernen können [1]. Lange blieb der praktische Nutzen aber begrenzt. Es fehlten Daten, Rechenleistung und robuste Trainingsverfahren [3].
Der Durchbruch kam, als mehrere Entwicklungen zusammenfielen: große digitale Datensätze, GPUs, bessere Optimierungsverfahren und Architekturen, die viele Schichten stabil trainierbar machten. Daraus entstand Deep Learning [3, 4].
„Deep" bedeutet hier nicht geheimnisvoll, sondern tief geschichtet. Ein tiefes Netz kann Repräsentationen auf mehreren Ebenen lernen. Bei Bildern können frühe Schichten Kanten erkennen, mittlere Schichten Formen und spätere Schichten ganze Objekte. Diese Idee hierarchischer Repräsentationen ist ein Kernpunkt des Deep-Learning-Durchbruchs [3, 4].
Warum mehr Schichten nicht automatisch besser sind
Tiefe hilft nur, wenn Training, Daten und Architektur zusammenpassen. Ein größeres Netz kann mehr lernen, aber auch mehr Fehler übernehmen. Es kann überangepasst werden, also Trainingsbeispiele zu genau nachbilden, statt robuste Muster zu lernen. Es kann Verzerrungen aus Daten verstärken. Und es kann plausible Ausgaben erzeugen, die trotzdem falsch sind [4, 9].
Darum ist moderne KI nicht nur eine Frage von Modellgröße. Entscheidend sind Datenqualität, Trainingsziel, Evaluation, Infrastruktur und der konkrete Einsatzzweck.
Was neuronale Netze gut können
Neuronale Netze sind besonders stark, wenn Muster in großen Datenmengen stecken. Sie erkennen Objekte in Bildern, übersetzen Texte, klassifizieren Signale, transkribieren Sprache, generieren Code und finden Zusammenhänge in komplexen Datensätzen. LeCun, Bengio und Hinton beschreiben genau diese Stärke als zentrale Ursache für die Fortschritte in Sprach-, Bild- und Signalverarbeitung [3].
Ihre Stärke liegt darin, dass sie Merkmale nicht vollständig von Menschen vorgegeben bekommen müssen. Stattdessen lernen sie interne Repräsentationen, die für eine Aufgabe nützlich sind. Genau das macht sie so flexibel. Dasselbe Grundprinzip kann für Bilder, Audio, Text, Sensorwerte oder medizinische Daten genutzt werden [3, 4].
In der Praxis bedeutet das: Neuronale Netze sind Werkzeuge für unscharfe, hochdimensionale Probleme. Sie glänzen dort, wo Regeln schwer zu formulieren sind, aber genügend gute Beispiele existieren.
Wo neuronale Netze scheitern können
Die gleiche Flexibilität macht neuronale Netze schwer durchschaubar. Sie liefern nicht automatisch eine Begründung, die ein Mensch direkt prüfen kann. Sie können auf Daten reagieren, die mit der eigentlichen Aufgabe nur zufällig zusammenhängen. Sie können Vorurteile aus Trainingsdaten übernehmen. Und sie können bei Eingaben scheitern, die für Menschen harmlos wirken, aber außerhalb der gelernten Verteilung liegen [4, 9].
Besonders bei generativen Modellen wird das sichtbar. Ein Sprachmodell erzeugt wahrscheinliche Fortsetzungen. Das kann zu hilfreichen Erklärungen führen, aber auch zu überzeugend klingenden Fehlern. Halluzinationen sind deshalb kein kleiner Schönheitsfehler am Rand. Die Forschung zu Natural Language Generation beschreibt Halluzinationen als ein wiederkehrendes Problem, bei dem generierte Texte nicht ausreichend durch Eingabe, Kontext oder Faktenbasis gedeckt sind [7].
Das macht neuronale Netze nicht unbrauchbar. Es bedeutet nur, dass man sie als statistische Systeme behandeln muss. Je wichtiger die Entscheidung, desto wichtiger werden Prüfung, Quellen, Messverfahren und menschliche Verantwortung.
Was neuronale Netze mit LLMs zu tun haben
Large Language Models sind eine besonders sichtbare Form neuronaler Netze. Viele moderne LLMs sind autoregressive Sprachmodelle: Sie werden darauf trainiert, aus einem Kontext das nächste Token vorherzusagen. Bei sehr großem Maßstab können daraus Fähigkeiten wie Zusammenfassen, Übersetzen, Programmieren, Erklären und Argumentieren entstehen [6].
Der große Wendepunkt für moderne Sprachmodelle war die Transformer-Architektur. Sie nutzt Attention, um Beziehungen zwischen vielen Positionen in einem Text gleichzeitig zu modellieren, und wurde ursprünglich als Architektur für Sequenzverarbeitung ohne rekurrente oder konvolutionale Hauptstruktur vorgeschlagen [5]. Dadurch können Modelle Zusammenhänge im Kontext anders verarbeiten als ältere Sequenzmodelle [5].
Aber auch bei LLMs bleibt die Grundlogik dieselbe: Eingaben werden in Zahlen übersetzt, durch viele gelernte Transformationen geschickt und am Ende wieder in Text verwandelt. Das Chatfenster ist nur die Oberfläche. Darunter liegen Gewichte, Daten, Training, Hardware und Inferenzsysteme.
Genau deshalb führen neuronale Netze direkt zu den nächsten technischen Fragen: Welche Hardware braucht lokale KI? Warum entscheidet Speicherbandbreite über Geschwindigkeit? Und weshalb können CUDA, Treiber und Compute Capability darüber bestimmen, ob ein Modell überhaupt läuft? Diese Infrastrukturthemen werden in den CUDA- und Hardware-Beiträgen weitergeführt [10, 11].
Fazit: Lernen aus Beispielen ist die eigentliche Revolution
Neuronale Netze sind nicht deshalb wichtig, weil sie ein Gehirn nachbauen. Sie sind wichtig, weil sie eine andere Art von Software ermöglichen. Statt jede Regel zu formulieren, zeigt man Beispiele. Statt Verhalten vollständig zu programmieren, trainiert man Parameter. Statt starre Entscheidungsbäume zu bauen, entstehen flexible Mustererkenner.
Das ist die eigentliche Verschiebung: Maschinen können aus Daten Strukturen lernen, die Menschen nicht sauber als Regelwerk beschreiben könnten. Diese Fähigkeit erklärt nicht alles an moderner KI, aber sie ist ihr Fundament.
Wer neuronale Netze versteht, sieht heutige KI nüchterner und spannender zugleich. Weniger Magie, mehr Mechanik. Weniger Mythos, mehr Handwerk. Und genau dort beginnt der bessere Einstieg in LLMs, lokale Modelle, GPU-Infrastruktur und die Frage, welche KI-Systeme im Alltag wirklich nützlich sind.
Quellen
[1] Frank Rosenblatt. The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 1958. https://doi.org/10.1037/h0042519
[2] David E. Rumelhart, Geoffrey E. Hinton, Ronald J. Williams. Learning representations by back-propagating errors. Nature, 1986. https://doi.org/10.1038/323533a0
[3] Yann LeCun, Yoshua Bengio, Geoffrey Hinton. Deep learning. Nature, 2015. https://doi.org/10.1038/nature14539
[4] Ian Goodfellow, Yoshua Bengio, Aaron Courville. Deep Learning. MIT Press, 2016. https://www.deeplearningbook.org/
[5] Ashish Vaswani, Noam Shazeer, Niki Parmar et al. Attention Is All You Need. arXiv, 2017. https://arxiv.org/abs/1706.03762
[6] Tom B. Brown, Benjamin Mann, Nick Ryder et al. Language Models are Few-Shot Learners. arXiv, 2020. https://arxiv.org/abs/2005.14165
[7] Ziwei Ji, Nayeon Lee, Rita Frieske et al. Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, 2023. https://doi.org/10.1145/3571730
[8] Nicholas Carlini, Florian Tramèr, Eric Wallace et al. Extracting Training Data from Large Language Models. USENIX Security, 2021. https://www.usenix.org/conference/usenixsecurity21/presentation/carlini-extracting
[9] Emily M. Bender, Timnit Gebru, Angelina McMillan-Major, Shmargaret Shmitchell. On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? FAccT, 2021. https://doi.org/10.1145/3442188.3445922
[10] AI Crack Heads. CUDA, Compute Capability und Treiber: Warum neue NVIDIA-GPUs plötzlich nicht mehr laufen. https://ai-crack-heads.com/de/blog/cuda-compute-capability-treiber
[11] AI Crack Heads. DGX Spark vs. RTX 5090 vs. RTX PRO 6000 Blackwell: Welche NVIDIA-Plattform eignet sich für welche KI-Workloads? https://ai-crack-heads.com/de/blog/dgx-spark-vs-rtx-blackwell-teil1