Vom Auspacken zum privaten Heim-Gehirn: Warum ich machine_setup_automation gebaut habe
2026-08-21 · Julian Weber
Du hast es getan. Du hast einen "Strix-Halo" oder einen "DGX Spark" gekauft. Das ist Hardware, die lokale LLM-Experimente endlich machbar macht, ohne ein Enterprise-Budget zu benötigen. Die Kiste ist ausgepackt, die Lüfter sind leise, und jetzt folgt erst einmal der anstrengende Teil: eine frische Ubuntu-Installation in eine Maschine zu verwandeln, die tatsächlich Modelle bereitstellen kann.
Zwischen der GPU-Toolchain, der Inference-Engine, dem Modell-Proxy, der Web-UI, SSHD Konfiguration, Coding Agent Setup, der Firewall und einem Monitoring-Stack besteht ein ordentlicher Inference-Server eigentlich aus zehn verschiedene Installationsprojekte. Machst du das von Hand, verbringst du ein ganzes Wochenende mit Klempnerarbeiten, bevor auch nur ein einziges Token generiert wird.
Also habe ich kwisatz gebaut: ein Repository aus modularen, idempotenten Bash-Skripten plus einem Orchestrator, der aus einem blanken Ubuntu System mit einer einzigen YAML-Datei und einem Befehl einen funktionierenden Inference-Server macht. Hier ist die Geschichte dazu und eine kurze Tour durch den Stack — denn ich vermute, die meisten von euch haben noch nie einen Inference-Server betrieben.
Warum das Ganze?
Als DevOps-Profi lebe ich nach einer Regel: Wenn ich etwas zweimal mache, wird es zu Code. Also ist von Tag eins an jeder Schritt meiner Maschinen-Provisionierung — Docker, GPU-Builds, Inference-Dienste, Firewall, Agenten — als eigenes Skript in dieses Repository eingeflossen.
Die Skripte lagen alle an einem Ort, aber eine neue Maschine bedeutete trotzdem: Ich musste mich erinnern, welche Skripte es gibt, in welcher Reihenfolge sie laufen müssen und welche Umgebungsvariablen jedes davon braucht. Das ist kein Setup — das ist ein Ritual, das nur ich durchführen konnte.
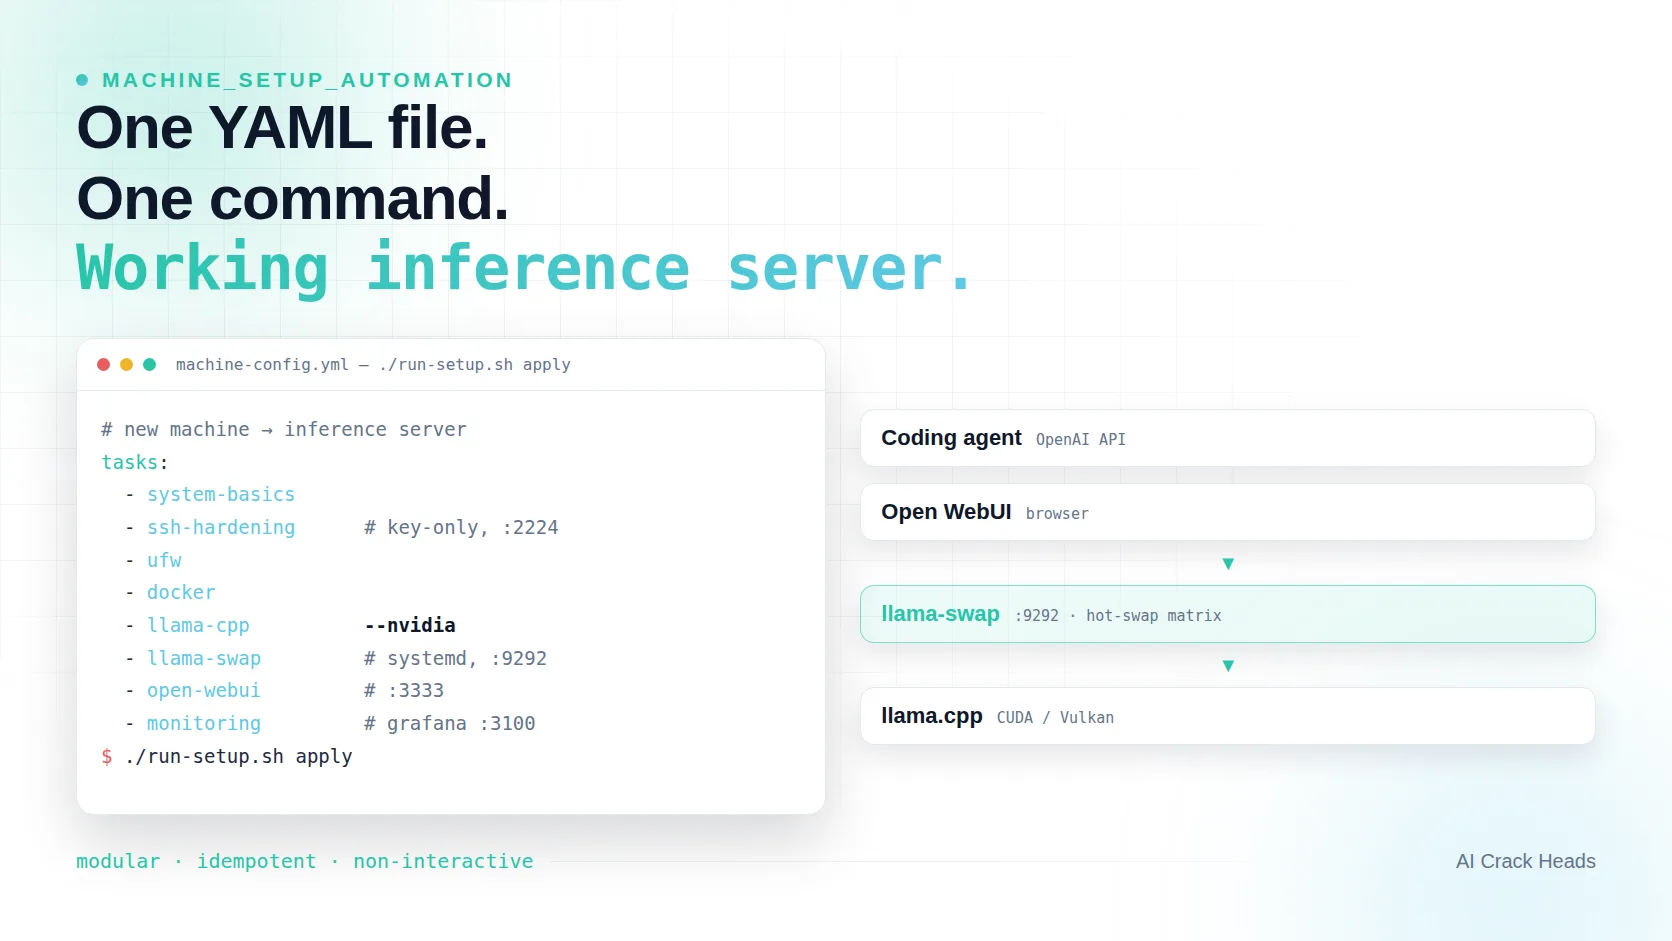
Die Lösung war ein schlanker Orchestrator obendrauf. run-setup.sh liest eine YAML-Konfiguration, führt jedes aktivierte Skript aus — in der von dir angegebenen Reihenfolge —, überspringt die nicht benötigten, macht nach einem einzelnen Fehler weiter und gibt am Ende eine Zusammenfassung aus. Deine Konfigurationsdatei wurde zum Betriebshandbuch. Eine Maschine, für die ich früher persönlich anwesend sein musste, braucht jetzt nur noch das Repository, eine Konfiguration und ./run-setup.sh apply.
Der Inference-Stack, erklärt
Bevor es zum Tutorial geht, lernen wir erst mal die Besetzung kennen. Das Inference-Preset im Repository — machine-config-inference.yml.example — installiert und konfiguriert folgende Komponenten:
- llama.cpp – die Engine, die das eigentliche Denken übernimmt. Sie führt LLMs lokal aus, direkt auf deiner GPU (CUDA bei NVIDIA, Vulkan bei AMD), aus dem Quellcode für deine Hardware kompiliert. Sie stellt eine OpenAI-kompatible API bereit. Falls du sonst nichts weißt: Hier lebt dein Modell.
- llama-swap – der Türsteher vor der Engine. Ein kleiner Go-Proxy, der zwischen deinen Clients und deinen Inference-Servern sitzt. Er beobachtet das Feld
modelin jeder Anfrage, startet bei Bedarf den passenden llama.cpp-Server und tauscht Modelle im laufenden Betrieb aus ("Hot-Swap"), wenn du ein anderes Modell anfragst. Da eine GPU nicht jedes Modell gleichzeitig im Speicher halten kann, führt llama-swap eine kostenbasierte Swap-Matrix, die das am wenigsten wertvolle Modell entfernt, wenn ein neues RAM benötigt. Außerdem gibt es dir eine Web-UI (/ui), um zu sehen, welche Modelle geladen sind, und sie manuell zu verwalten. - Open WebUI – eine ChatGPT-artige Weboberfläche, um deine lokalen Modelle im Browser zu durchstöbern und mit ihnen zu chatten.
- vLLM – ein alternativer, durchsatzstarker Inference-Server für Fälle, in denen die reine Token-pro-Sekunde-Rate wichtig ist.
- Pi Coding Agent – ja, das Repository installiert seinen eigenen Agenten, sodass die Maschine sofort für Coding-Arbeit nutzbar ist, nicht nur für Chats.
- Monitoring – Prometheus, Grafana, Node Exporter und cAdvisor in Docker. Jeder Container mit dem Label
prometheus.scrape=truewird automatisch erkannt und abgefragt, und Grafana wird mit vorkonfigurierten Dashboards ausgeliefert.
Der Ablauf, der diesen Stack ausmacht:
Coding Agent ──┐
               │   OpenAI-kompatible API ·  "model": "qwen3-30b"
Open WebUI ────┴──────────────►  llama-swap  ·  Proxy auf :9292
                                          │
                                          │   lädt / tauscht im laufenden Betrieb
                                          ▼
                                 llama.cpp-Server
                                 (CUDA- oder Vulkan-Backend)
Jeder Client — ein Coding Agent, Open WebUI, curl — spricht mit llama-swap über die Standard-OpenAI-API. llama-swap sorgt dafür, dass das angeforderte Modell auf llama.cpp läuft, und leitet die Anfrage dorthin weiter. Modelle wechselst du, indem du eine einzige Zeichenkette in deiner Anfrage änderst.
Schnellstart: Von der neuen Maschine zum Inference-Server
Auf einer frischen Ubuntu-Maschine:
git clone https://github.com/Kubementat/kwisatz.git
cd kwisatz

# Starte mit dem Inference-Preset
cp machine-config-inference.yml.example machine-config.yml

# Schau dir die Konfiguration an und passe Werte für dich an
nano machine-config.yml
Das Preset aktiviert, in dieser Reihenfolge: System-Grundlagen, gehärtetes SSH (nur Schlüssel-Authentifizierung, Port 2224), UFW-Firewall-Regeln, Docker, llama.cpp (gebaut mit dem passenden GPU-Backend), llama-swap als systemd-Dienst, Open WebUI, den Pi-Agenten, vLLM und den Monitoring-Stack. Jeder Eintrag ist inline mit seinen Umgebungsvariablen und Standardwerten dokumentiert — passe die Ports an, wähle dein GPU-Backend (--nvidia, --amd, --cpu) oder setze einen Dienst einfach auf enabled: false. Dann:
# Genau ansehen, was in welcher Reihenfolge ausgeführt wird
./run-setup.sh status

# Los geht's
./run-setup.sh apply
Alles läuft nicht-interaktiv und idempotent: Die Skripte geben ihren Fortschritt aus und hinterlassen dir einen funktionierenden Server — llama.cpp für deine GPU gebaut, llama-swap leitet Anfragen auf :9292, eine Web-UI auf :3333, Dashboards auf :3100.
Es gibt außerdem einen begleitenden Agent Skill im Repository (skills/machine-setup-automation-assistant/SKILL.md). Sag deinem Coding Agent nach dem auschecken des Repos einfach wo dieser Skill liegt und er kann dich durch die Auswahl und Ausführung des richtigen Setups führen. Und so konfigurieren KI-Agenten die KI-Infrastruktur, die sie selbst betreibt.
Warum das wichtig ist
Der ganze Sinn dahinter ist, dass deine Zeit in Modelle und Experimente fließen sollte, nicht in apt install-Archäologie. Wenn du einen reproduzierbaren, dokumentierten, idempotenten Weg von frischem Ubuntu zu einem funktionierenden lokalen Inference-Server suchst — einen, den du (oder ein Agent) auf der nächsten Maschine, die du kaufst, wiederholen kannst — dann ist das dein Repo.
Pull Requests sind willkommen.
Das Repository findest du unter github.com/Kubementat/kwisatz.
Die Zukunft dieses Projekts
Von den vielen Projekten, die ich implementiert habe, um mit KI Tools und Modellen zu spielen und sie auszuarbeiten ist dies dasjenige, das ich täglich nutze, um meinen DGX und Halo rund um die Uhr laufen zu lassen. Aktuell verbessere ich viele der bestehenden Skripte und füge neue Funktionen hinzu, z. B. eine „Modell-Auto-Konfiguration" — Installer starten, und LLM-Gewichte sowie KI-Agenten-Konfiguration werden automatisch für dich erledigt. Das Ziel dieses Projektes ist es jedem zu ermöglichen, sein eigenes privates „Brain at Home"-Projekt zu betreiben.
Anhang: Tools & Dokumentation
| Tool | Was es ist | Doku |
|---|---|---|
| llama.cpp | Lokale LLM-Inference-Engine, GPU oder CPU | GitHub · Doku |
| llama-swap | Multi-Modell-Proxy mit Hot-Swapping | GitHub · Wiki |
| Open WebUI | ChatGPT-artige Web-UI | GitHub · Doku |
| vLLM | Durchsatzstarke Inference-Engine | GitHub · Doku |
| Prometheus | Metriken-Erfassung & Alarmierung | prometheus.io |
| Grafana | Dashboards & Visualisierung | grafana.com |
| Node Exporter | Host-Metriken für Prometheus | GitHub |
| cAdvisor | Ressourcen-Metriken pro Container | GitHub |
Weiterer Projektkontext: README · CONTEXT.md · Agent Skill · NVIDIA DGX Spark